Контекст
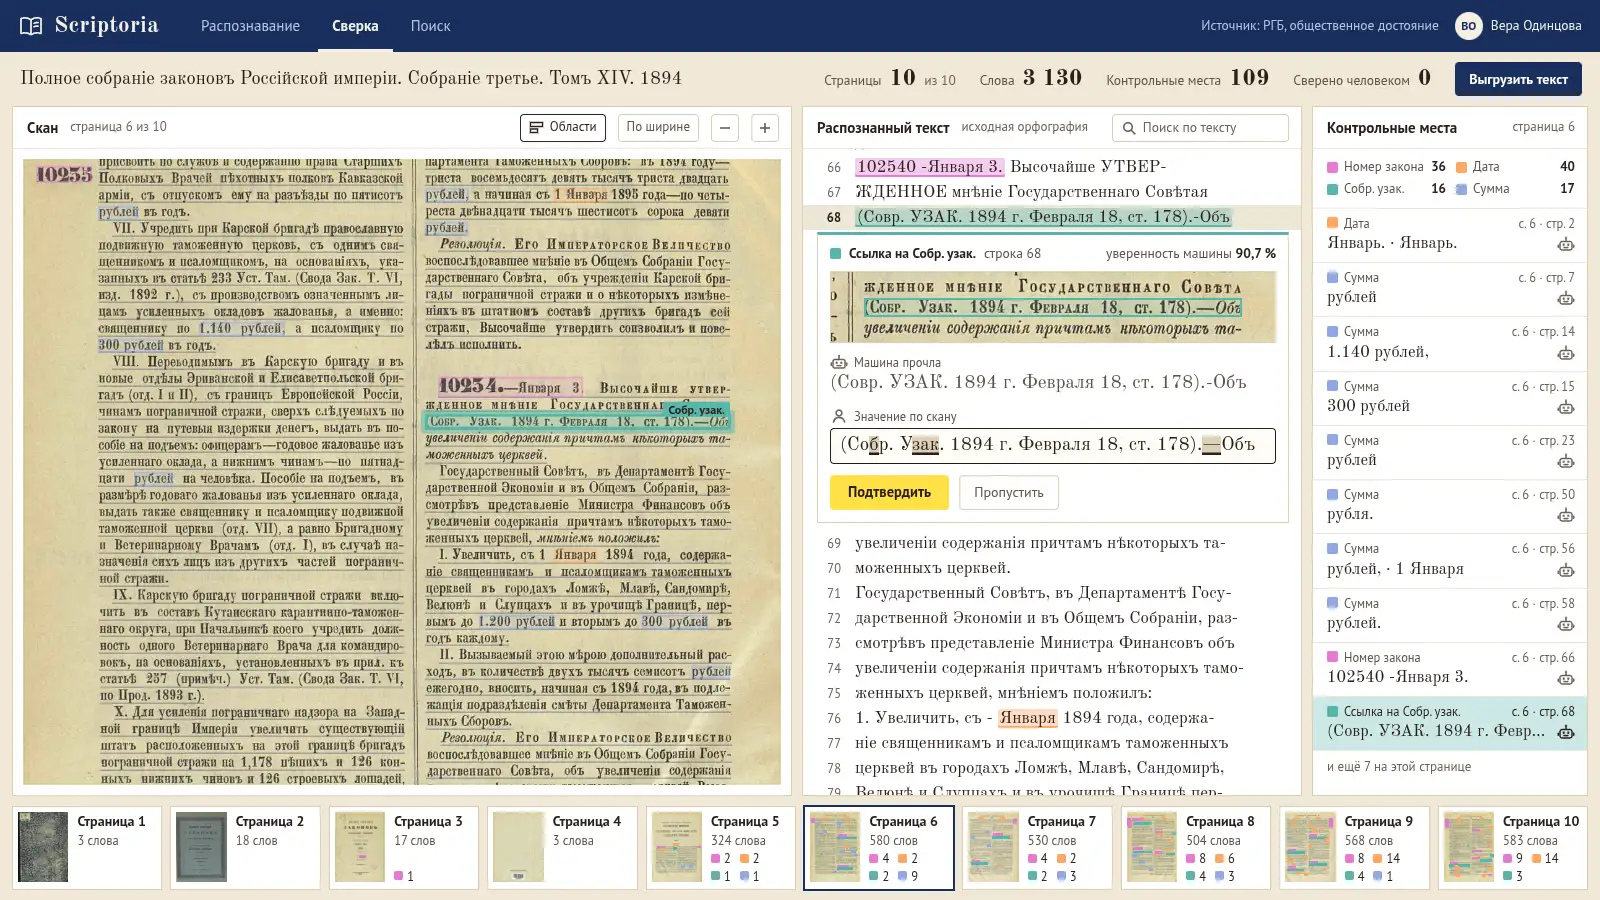
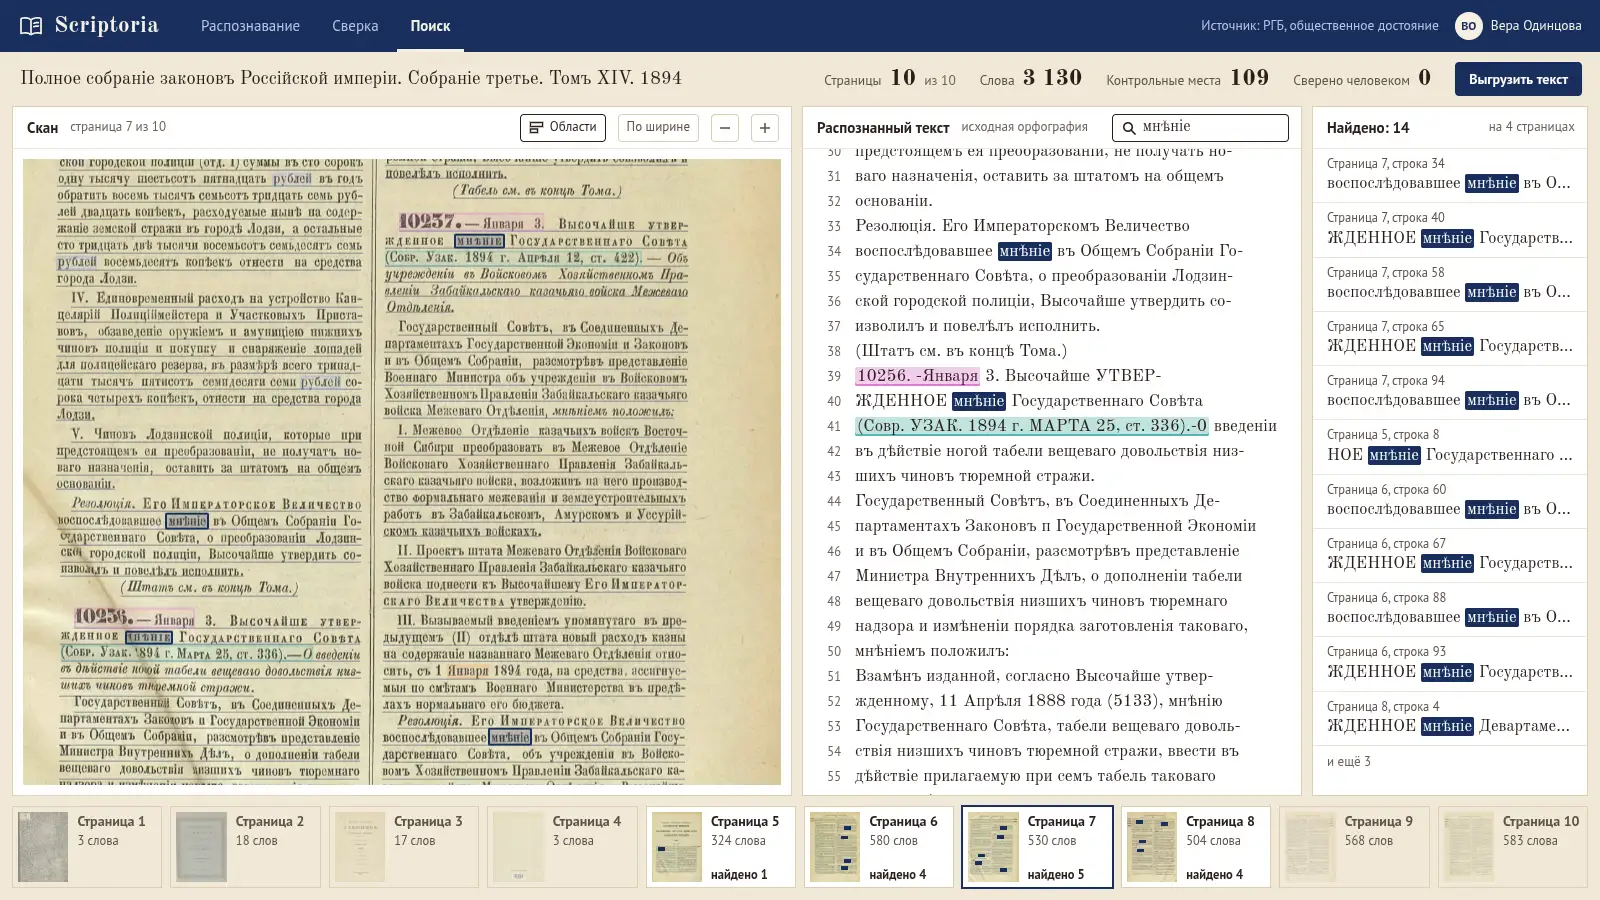
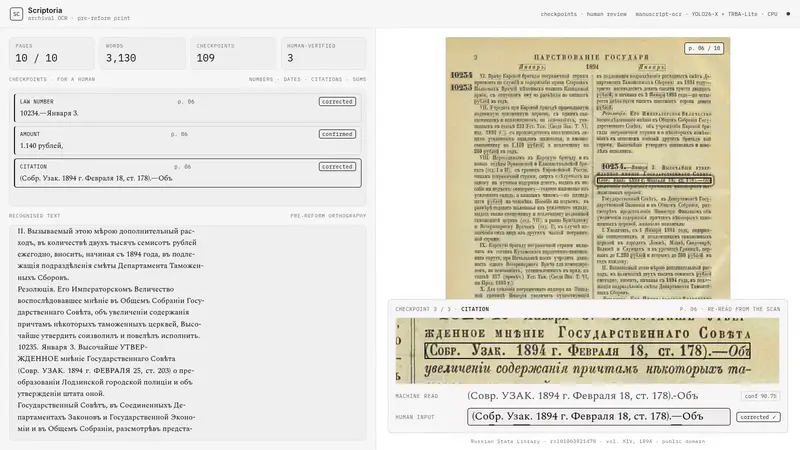
Дореформенная печать (ѣ, і, ъ) в две колонки: текстовый слой библиотеки рвёт слова и перемешивает колонки, искать по нему нельзя.
Задача
Поставить распознавание архива на поток и оставить человеку то, что держит смысл документа.
Решение
manuscript-ocr на CPU: детектор YOLO26-X и распознаватель TRBA-Lite с дореформенным алфавитом, своя раскладка по колонкам. Контрольные места — номера законов, даты, ссылки на Собрание узаконений, суммы — уходят человеку: он перечитывает скан и вводит значение.
Результат
Первые 10 страниц Полного собрания законов, т. XIV, 1894 (РГБ): 3 130 слов примерно за 2,5 минуты на CPU. Текст в исходной орфографии, по нему работает поиск; контрольные места сверены человеком.